タグ: LLM

  • Difyのモデルの選び方——「いちばん賢いもの」を選ばなくていい

    モデルを選ぶ画面を開くと、候補がいくつも並んでいます。名前を見ても違いが分からないので、多くの方はこう考えます。「とりあえず、いちばん賢そうなものを選んでおけばいい」

    気持ちは分かるのですが、これは必ずしも正解ではありません。 用途によっては、賢いモデルを選んだせいで使いにくくなることがあります。

    たとえば、答えが返ってくるまで待たされる。あるいは、同じ作業なのに費用がふくらむ。能力が高いことと、その用途に合っていることは別の話です。

    この記事では、どのモデルがおすすめかというランキングは出しません。 モデルの顔ぶれは入れ替わりますし、順位を覚えても次に選ぶときには使えないからです。代わりに、自分で選べるようになるための3つの軸をお渡しします。

    なお、この記事の内容は2026年9月時点のものです。 選べるモデルの種類は変わっていきますが、選び方の考え方自体は変わりにくいはずです。

    選ぶときに見る3つの軸

    モデルを比べるとき、見るところは大きく3つです。

    ① 精度

    どれだけ正確に、意図をくんだ答えを返してくれるかです。

    複雑な指示を理解する力や、筋道立てて考える力がここに入ります。難しい判断を任せたいときほど、この軸が効いてきます。

    たとえば「条件がいくつも絡む質問に答える」「長い文章から必要なところだけ抜き出す」といった作業です。逆に、決まった形に整えるだけの作業なら、ここに力を入れる必要はあまりありません。

    ② 速度

    答えが返ってくるまでの早さです。

    一度きりの作業なら数秒の差は気になりません。ですが、何人もが同時に使うツールや、たくさんの件数を処理する用途では、この差が積み重なります。

    とくに、人が画面の前で待つ形の使い方——社内の問い合わせに答えるボットのようなもの——では、返事の遅さがそのまま「使いにくい」という印象になります。

    ③ 費用

    使うとどれだけかかるかです。

    一般に、高い能力を持つモデルほど費用も高くなります。ひとりで試している間は小さな差でも、業務で回し始めると効いてきます。

    同じ作業を繰り返すほど差は開くので、一度きりの作業なのか、毎日動かすものなのかで、この軸の重みは変わります。

    費用の全体像は料金を扱った記事で整理しているので、そちらをご覧ください。Difyの料金プランとコストの基本

    3つは、同時には満たせない

    ここが大事な点です。この3つは、都合よく全部そろいません。

    精度の高いモデルは、たいてい時間も費用もかかります。速くて安いモデルは、込み入った判断が苦手なことが多くなります。どれかを取れば、どれかを譲る。この関係を「トレードオフ」と呼びます。

    だから「いちばん賢いモデル」は、いちばん遅くて、いちばん高いモデルでもあるわけです。何をするにもそれを選ぶ、というのは合理的ではありません。

    モデルを選ぶというのは、何を諦めるかを決めることでもあります。
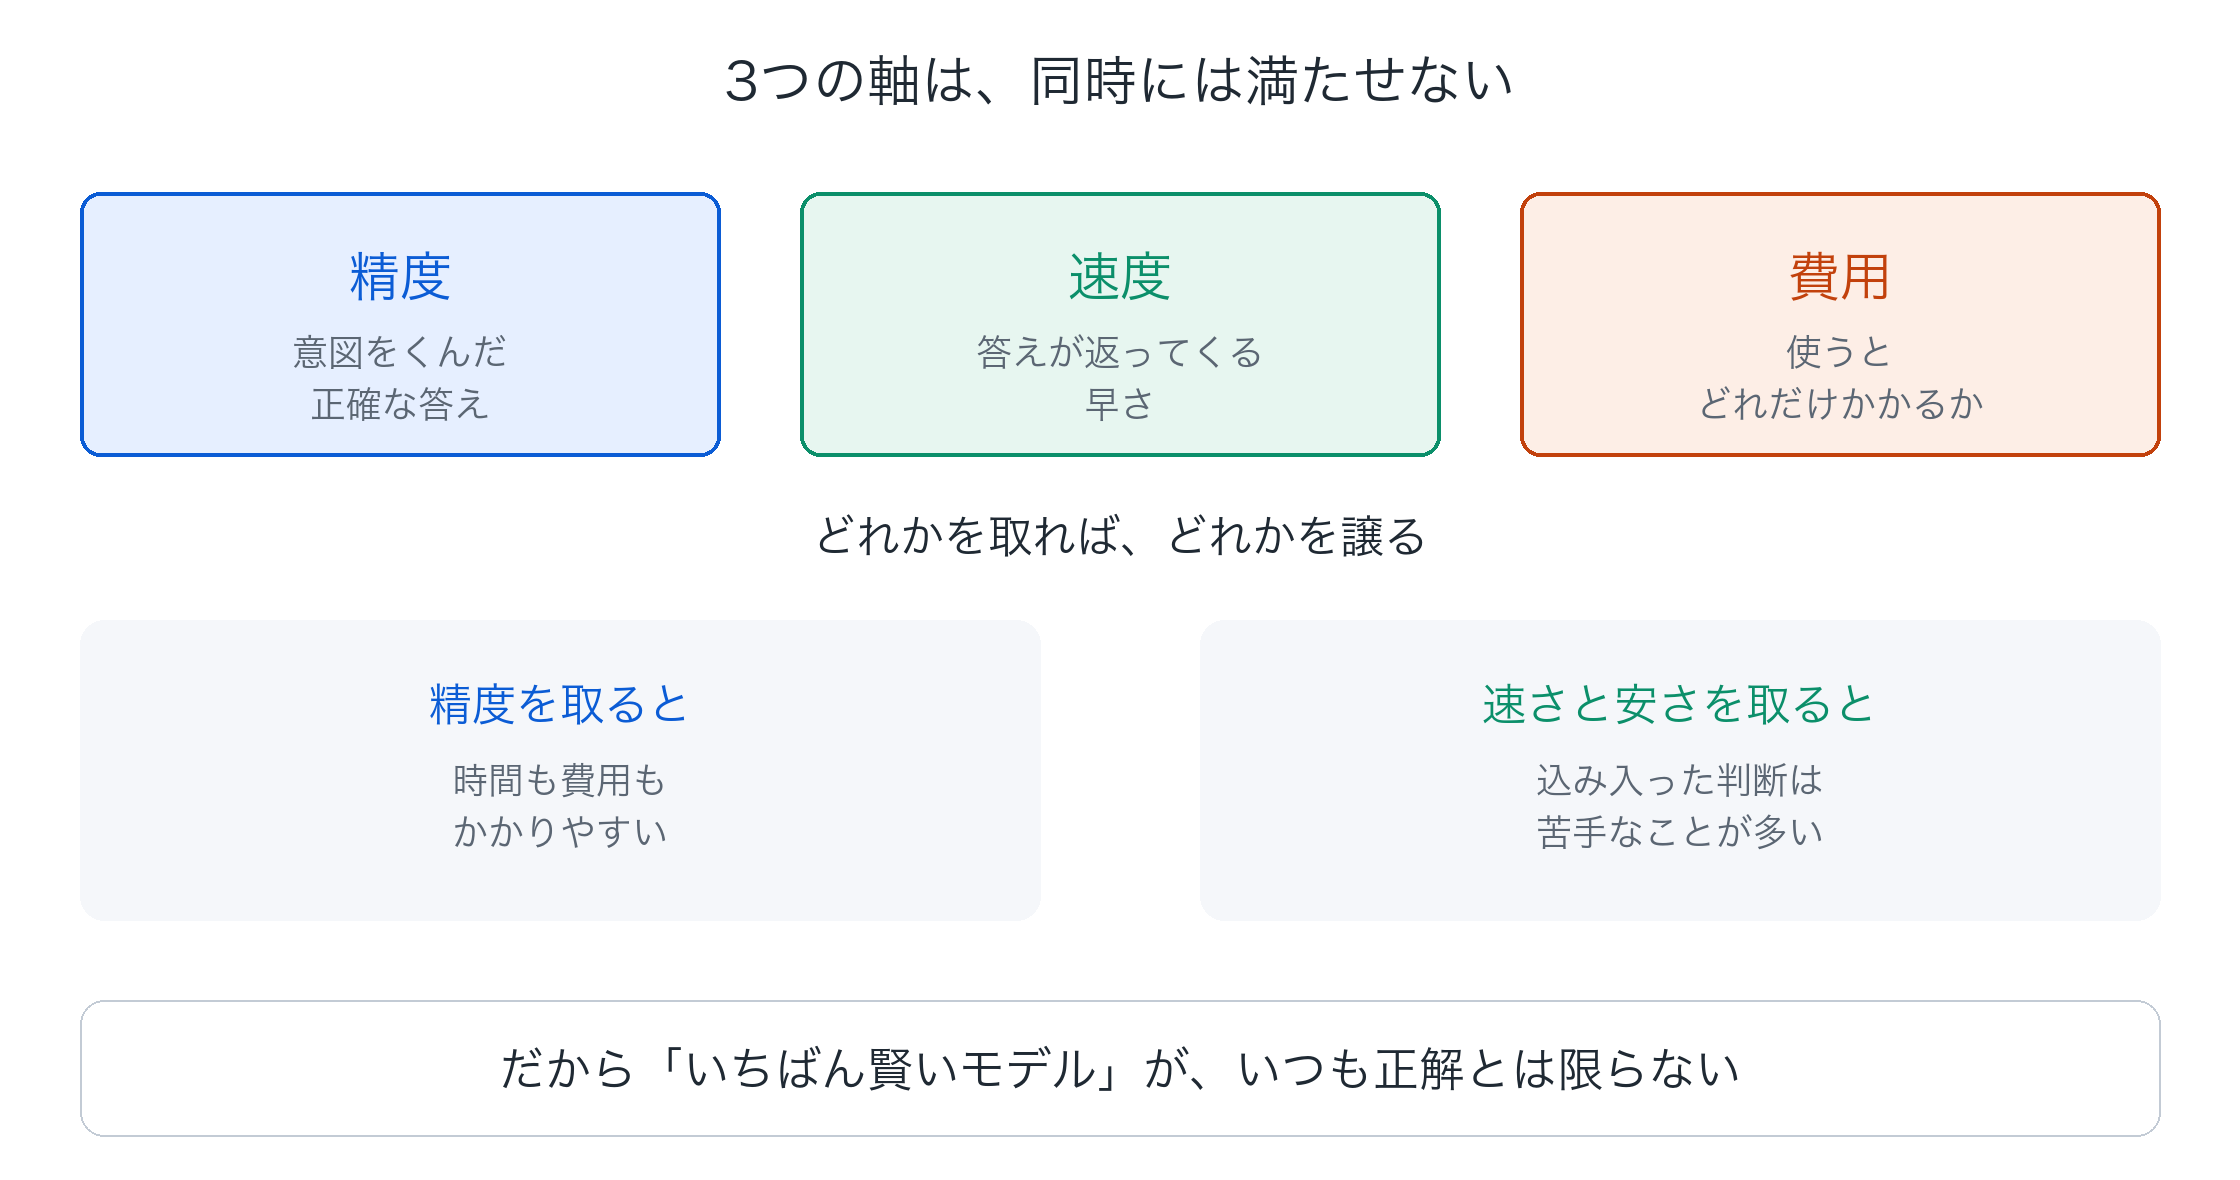
    精度・速度・費用の3つの軸と、それらが同時には満たせないことを示した図。精度を取ると時間も費用もかかりやすく、速さと安さを取ると込み入った判断は苦手なことが多い
    どれかを取れば、どれかを譲ることになります

    用途から考える

    では、どう決めるのか。先に用途を決めて、そこから優先する軸を選びます。

    たとえば、社内の規程を読み込ませて「経費精算のルール」を答えるボットを作るとします。ここで間違った金額や条件を答えてしまうと、業務に支障が出ます。多少遅くても、正確さを優先したい場面です。

    一方で、毎日届く文章をどんどん要約させたいとします。1件あたりの結果が多少そっけなくても、数をこなせることのほうが大事かもしれません。

    同じ「AIに任せる」でも、優先するものが逆になります。

    やりたいこと優先したい軸
    間違いが許されない回答をさせたい精度
    たくさんの件数をさばきたい速度・費用
    社内で広く使ってもらいたい速度・費用
    込み入った判断を任せたい精度

    用途がはっきりすれば、選択肢はぐっと減ります。 迷うのは、たいてい「何に使うか」が決まっていないときです。

    もうひとつ、同じ用途でも段階によって変わります。 試している間は、費用を抑えて数多く試せるほうが助かるでしょう。実際に業務で使い始めてからは、多少かかっても外さないほうが大事になる、ということが起こります。

    最初の1つをどう決めるか

    とはいえ、最初から用途がはっきりしていないこともあります。その場合はこうしてください。

    初期設定のモデルのまま、まず始めてみる。

    Dify Cloudに登録した時点で、標準で使われるモデルはすでに決まっています。設定のしかたは前の記事で扱いました。モデルプロバイダーの設定とAPIキー登録
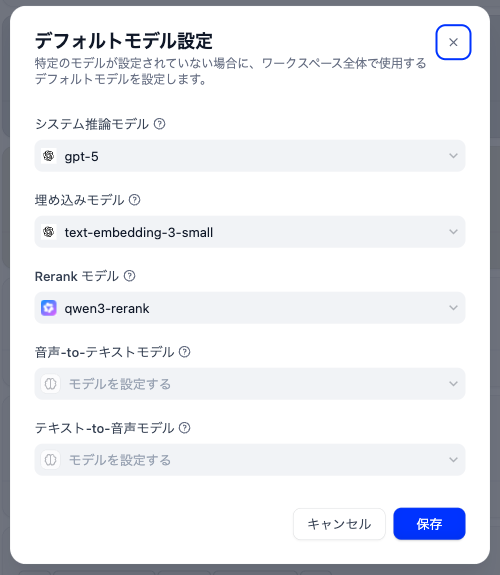
    Difyのデフォルトモデル設定のダイアログ。システム推論モデル、埋め込みモデル、Rerankモデルなどの選択欄が並び、それぞれに既定のモデルが設定されている
    2026年9月12日時点の設定画面。いちばん上の「システム推論モデル」が、標準で使われるモデルにあたります

    そのうえで、使ってみて困ったら変えます。

    • 答えがずれる、指示をくみ取ってくれない → 精度の軸を上げる
    • 返ってくるのが遅い、待たされる → 速度の軸を優先する
    • 思ったより費用がかさむ → 費用の軸を見直す

    モデルは後からいくらでも選び直せます。 最初の選択は、やり直しの効く仮置きだと考えてください。

    作ったものを壊さずに、モデルだけを差し替えられます。最初に悩む時間より、一度動かしてみて気づくことのほうが多いはずです。

    比べるなら、同じ条件で

    もうひとつ。複数のモデルを比べるときは、同じ指示を投げて見比べてください。

    指示の文面が違うと、モデルの差なのか指示の差なのか分からなくなります。同じ入力で見比べれば、その用途でどちらが合っているかが見えてきます。

    そのとき使うのは、実際に来そうな入力にしてください。きれいに整えた例文よりも、現場で飛んできそうな雑な質問のほうが、モデルの差ははっきり出ます。

    なお、同じモデルでも設定を変えると答えの傾向は変わります。その調整のしかたは別の記事で扱います。【内部リンク:記事025】(公開後追加)

    まとめ

    この記事では、モデルを選ぶときの考え方を見てきました。要点を振り返ります。

    • 見る軸は精度・速度・費用の3つ
    • 3つは同時に満たせない。 どれかを取れば、どれかを譲る
    • だから「いちばん賢いモデル」が、いつも正解とは限らない
    • 用途を先に決めれば、優先する軸が決まる
    • 迷ったら初期設定のまま始めて、困ったら変える
    • 比べるときは同じ指示で見比べる

    モデルの顔ぶれはこれからも入れ替わりますが、この3つの軸は残ります。 新しい名前を見かけたときも、「精度・速度・費用のどこが強いのか」と見れば、同じように判断できます。

    準備はこれで整いました。次の記事では、いよいよ実際にチャットボットを作ります。 ここまでに用意したものを使って、動くものを1つ仕上げましょう。はじめてのチャットボットを作る

    なお、モデル(LLM)そのものの仕組み——トークンやコンテキストといった用語——は、シリーズの前半で扱っています。用語があやふやなときは戻ってみてください。Dify理解に必要な生成AI・LLMの基礎知識

    ※本記事の内容は2026年9月時点のものです。選べるモデルの種類・名称・性能は変更されることがあります。実際に選ぶ際は、ご自身の画面とあわせてご確認ください。

  • Dify理解に必要な生成AI・LLMの基礎知識:LLMとは何かを初心者向けに解説

    「AIの仕組みなんて知らなくても、Difyは使えるんじゃないの?」——そのとおりです。ただ、ほんの少しだけ用語を知っておくと、Difyの設定画面でつまずかずに済みます。この記事では、LLMとは何かをはじめ、Difyを使うときに必ず出会う生成AIの基礎知識だけを、初心者向けにやさしく整理します。数式は一切使いません。

    生成AIとLLMの関係

    まず、よく混同される「生成AI」と「LLM」の関係を整理します。

    生成AIとは、文章・画像・音声・動画などの新しいコンテンツを作り出すAIの総称です。その中で、特に文章(言葉)を扱う中心的な仕組みがLLMです。

    つまり、生成AIという大きな箱の中に、文章担当のLLM、画像担当の画像生成AI……といった専門家がいるイメージです。Difyで主に使うのは、この文章担当のLLMです。

    LLMとは?一言で言うと

    LLMは「Large Language Model」の略で、日本語では大規模言語モデルと呼びます。名前は難しそうですが、やっていることはシンプルです。

    LLMは、インターネット上の膨大な文章を学習し、「ある言葉の次に来る、もっともそれらしい言葉」を予測する仕組みです。「こんにちは、今日はいい」と入力されたら、「天気」と続けるのが自然だ、と確率的に判断しているわけです。

    この「次の言葉を予測する」を高速で何度も繰り返すことで、まるで人間が書いたような文章が出来上がります。ChatGPTが自然に会話できるのも、この仕組みのおかげです。

    ここで大切なのは、LLMは意味を人間のように理解しているわけではない、という点です。あくまで「学習した膨大な文章のパターンから、統計的にもっともありそうな続き」を選んでいるだけです。

    とはいえ、学習した文章の量が桁違いに多いため、結果として驚くほど自然で役に立つ答えを返してくれます。この「賢いけれど、意味を分かっているわけではない」という感覚を持っておくと、後で出てくる注意点も腑に落ちやすくなります。

    Difyを使うと必ず出会う3つの用語

    LLMのイメージがつかめたら、次はDifyの画面でよく目にする3つの用語を押さえましょう。この3つが分かれば、設定でほとんど迷わなくなります。

    トークン

    トークンとは、AIが文章を処理するときの文字のかたまり(単位)です。AIは文章をそのまま読むのではなく、いったん細かいトークンに分解してから扱います。

    イメージとしては、長い文章を細切れにした付箋のようなものです。文字とトークンの対応はAIのモデルによって変わりますが、日本語ではおおむね1文字あたり1トークン前後を目安に考えておけば十分です。

    なぜこの用語が大事かというと、AIの利用料金はトークンの量で決まることが多いからです。長い文章をやり取りするほどトークンが増え、費用も増えます。料金の詳しい話は別の記事で扱いますが、「トークン=処理と料金の単位」とだけ覚えておけば十分です。

    コンテキスト

    コンテキストとは、AIが一度に見渡せる文章の範囲のことです。「文脈」と訳されることもあります。

    これは、AIの短期記憶の広さ、あるいは作業机の広さにたとえると分かりやすいでしょう。机が広ければたくさんの資料を一度に広げられますが、机からあふれた古い資料は見えなくなります。

    チャットボットと長く会話していると、最初のほうに話した内容をAIが「忘れた」ように見えることがあります。これは、会話が長くなってコンテキスト(机)からあふれてしまったためです。AIの記憶力が悪いわけでも、故障でもありません。仕組み上、そういうものなのです。

    この性質を知っておくと、「長い会話ではときどき要点を伝え直す」「一度に詰め込みすぎない」といった、ちょっとした工夫が自然とできるようになります。Difyでアプリを作るときにも、この考え方が地味に効いてきます。

    モデル

    モデルとは、いわばAIの頭脳の種類です。世の中にはGPT、Claude、Geminiなど複数のLLMがあり、それぞれ得意なことや性格が少しずつ違います。

    Difyでは、こうしたモデルを選んで使えます。料理でいえば、同じレシピでも「どの料理人に作ってもらうか」を選べるようなものです。

    モデルによって、得意な言語、回答の速さ、利用料金、長い文章をどれだけ扱えるか(先ほどのコンテキストの広さ)などが異なります。だからこそ「どの用途にどのモデルを使うか」を選べることが、Difyのような道具の強みになります。

    とはいえ、最初から最適なモデルを見極める必要はありません。どのモデルを選べばよいかには考え方のコツがありますが、それは専門の記事で扱います。LLMモデルの選び方の基本ここでは「モデル=選べるAIの頭脳で、種類によって個性がある」で十分です。

    LLMが「もっともらしく間違える」理由

    もうひとつ、大切な性質があります。LLMは、堂々と間違えることがあるという点です。

    思い出してください。LLMは「次に来るそれらしい言葉」を予測しているのでした。つまり、事実かどうかを確かめているのではなく、それらしさを組み立てているのです。

    そのため、実際には存在しない情報を、いかにも本当らしく答えてしまうことがあります。この現象をハルシネーション(英語で「幻覚」の意味)と呼びます。

    たとえば、実在しない本のタイトルや、存在しない製品の機能を、さも当然のように説明してしまうことがあります。困るのは、その口ぶりがあまりに自然で自信ありげなため、知らないと信じ込んでしまう点です。

    だからこそ、AIの答えは「下書きや相談相手」として受け取り、重要なことは自分で裏を取る、という使い方が安心です。この前提を踏まえておくと、後のシリーズで「自社の資料にもとづいて答えさせる」といった工夫が、なぜ必要になるのかも見えてきます。

    これはLLMの根本的な性質なので、Difyを使ってもゼロにはできません。工夫で減らすことはできますが、「AIの答えは必ず正しい」と思い込まないことが、AIとうまく付き合う第一歩です。

    ここまで分かればDifyは十分に始められる

    最後に、学んだ用語がDifyのどこで出てくるかを地図として示します。

    用語どんなものDifyでの登場場面
    LLM次の言葉を予測して文章を作る仕組みアプリの回答を生み出す中心
    トークン文章を処理する単位利用状況・料金に関わる
    コンテキスト一度に見渡せる範囲長い会話で「忘れる」挙動の理由
    モデル選べるAIの頭脳の種類モデル選択の設定画面
    ハルシネーションもっともらしい誤り回答の正しさを過信しない理由

    この5つがぼんやりとでもイメージできれば、Difyの設定画面に出てくる言葉に臆することはありません。完璧に理解する必要はなく、実際に触りながら少しずつ馴染ませていけば大丈夫です。

    まとめ

    この記事では、Difyを使うために必要な生成AI・LLMの基礎だけを整理しました。要点は次のとおりです。

    • 生成AIは新しいコンテンツを作るAIの総称で、その中で文章を扱う中心がLLM(大規模言語モデル)
    • LLMは「次に来るそれらしい言葉」を予測して文章を作る
    • Difyでよく出会う用語は「トークン」「コンテキスト」「モデル」の3つ
    • LLMはもっともらしく間違える(ハルシネーション)ことがあり、答えを過信しない

    仕組みが少し分かると、AIが「どう指示すれば、思いどおりに動いてくれるのか」が気になってきます。次の記事では、そのAIへの指示=プロンプトとは何か、なぜ書き方で結果が変わるのかを、やさしく解説します。

    プロンプトとは何か?AIへの指示の基本